- 大数の法則の主張
- 標本平均の収束の速さ ($\sigma/\sqrt{n}$)
- 表と裏の回数の差が $\sqrt{n}$ で増大し、割合が収束する理由
- ギャンブラーの誤謬
- 上記を導くための期待値・分散・標準偏差の定義
大数の法則とは、試行回数を増やすほど、その平均 (標本平均) が期待値に近づくという法則です。
コイン投げでいえば、投げる回数を増やすほど表の割合が0.5に近づく、ということです。
本記事ではさらに、どの程度の回数で、どの程度近づくのかを扱います。結論を先に述べると、
表の割合のずれは、投げる回数 $n$ の平方根に反比例して ($1/\sqrt{n}$ で) 小さくなります。
精度を10倍にするには、回数を100倍にする必要があるということです。
この結果を導くために、まず期待値・分散・標準偏差を定義します。
期待値・分散・標準偏差
この節では、以降で使う3つの量を定義し、導出の鍵となる分散の2つの性質を確認します。
例として、コインを1回投げ、表なら1、裏なら0という値をとる量を $X$ とします。投げるまで値が決まらない量を確率変数と呼びます。
期待値
期待値とは、試行を何度もくり返したときの平均値です。記号では $E[X]$ と書きます。
「値 × その値が出る確率」の総和で計算できます。
$$E[X] = 1 \times \frac{1}{2} + 0 \times \frac{1}{2} = 0.5$$
以下では期待値を $\mu$ とも書きます。コイン投げでは $\mu = 0.5$ です。
分散
分散とは、結果が平均からどの程度ばらつくかを表す量です。定義は「平均からのズレの2乗の期待値」で、$\mathrm{Var}(X)$ と書きます。
$$\mathrm{Var}(X) = E\left[(X – \mu)^2\right]$$
ズレを2乗するのは、そのまま平均すると正と負が打ち消し合い、常に0になってしまうためです。
コイン投げでは、表のときのズレは $+0.5$、裏のときは $-0.5$ なので、
$$\mathrm{Var}(X) = (0.5)^2 \times \frac{1}{2} + (-0.5)^2 \times \frac{1}{2} = 0.25$$
標準偏差
標準偏差とは分散の平方根であり、平均からの典型的なズレの大きさを表します。記号では $\sigma$ と書きます。
$$\sigma = \sqrt{\mathrm{Var}(X)}$$
平方根をとるのは、2乗した分散のままでは元のデータと単位が異なるためです。
コイン投げでは $\sigma = \sqrt{0.25} = 0.5$ です。
分散の性質
以降の導出で使うのは、次の2つです。
- 性質1 : 定数倍すると、分散は2乗倍になる $\mathrm{Var}(aX) = a^2\,\mathrm{Var}(X)$
- 性質2 : 独立な確率変数の和の分散は、各分散の和になる $\mathrm{Var}(X_1 + X_2) = \mathrm{Var}(X_1) + \mathrm{Var}(X_2)$
性質1は、$X$ を $a$ 倍するとズレも $a$ 倍になり、分散はその2乗であることから従います。
性質2の「独立」とは、互いの結果が影響し合わないことです。コイン2枚で確認します。表の枚数 $X_1 + X_2$ は、0枚・1枚・2枚がそれぞれ確率 1/4・1/2・1/4 で起こり、平均は1です。分散は
$$(0-1)^2 \times \frac{1}{4} + (1-1)^2 \times \frac{1}{2} + (2-1)^2 \times \frac{1}{4} = 0.5$$
となり、1枚あたりの分散 0.25 の和に一致します。
直感的には、独立なズレは強め合う場合と打ち消し合う場合が同程度に起こるため、平均すると単純な和になります。
大数の法則
大数の法則とは、試行回数を増やすほど、その平均 (標本平均) が期待値に近づくという法則です。
コイン投げでいえば、投げる回数を増やすほど表の割合が0.5に近づく、ということです。
式で表すために、まず文字の定義を示します。
- $n$ : 試行回数
- $X_i$ : $i$ 回目の結果 (表なら1、裏なら0)
- $\bar{X}_n$ : $n$ 回の平均 (表が出た割合)
- $\mu$ : 1回あたりの期待値 (コイン投げでは0.5)
- $\sigma$ : 1回あたりの標準偏差 (コイン投げでは0.5)
$n$ 回の平均は
$$\bar{X}_n = \frac{X_1 + X_2 + \cdots + X_n}{n}$$
です。分子は表の回数なので、$\bar{X}_n$ は表が出た割合を表します。大数の法則は、これが期待値に近づくことを主張します。
$$\bar{X}_n \to \mu \quad (n \to \infty)$$
厳密には弱法則と強法則の2種類がありますが、応用上は上記の理解で十分です。
実際にコイン投げを8系列シミュレーションし、表の割合の推移を確かめます。
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(3)
n = 10000

fig, ax = plt.subplots(figsize=(10, 5))
for _ in range(8):
    x = (rng.random(n) < 0.5).astype(float)          # 表なら1、裏なら0
    ax.plot(np.arange(1, n+1), np.cumsum(x) / np.arange(1, n+1), lw=1, alpha=.8)

ax.axhline(.5, color="k", ls="--", lw=2, label="expectation 0.5")
ax.set_xscale("log")
ax.set_xlabel("number of trials (log)")
ax.set_ylabel("sample mean")
ax.legend()
plt.show()
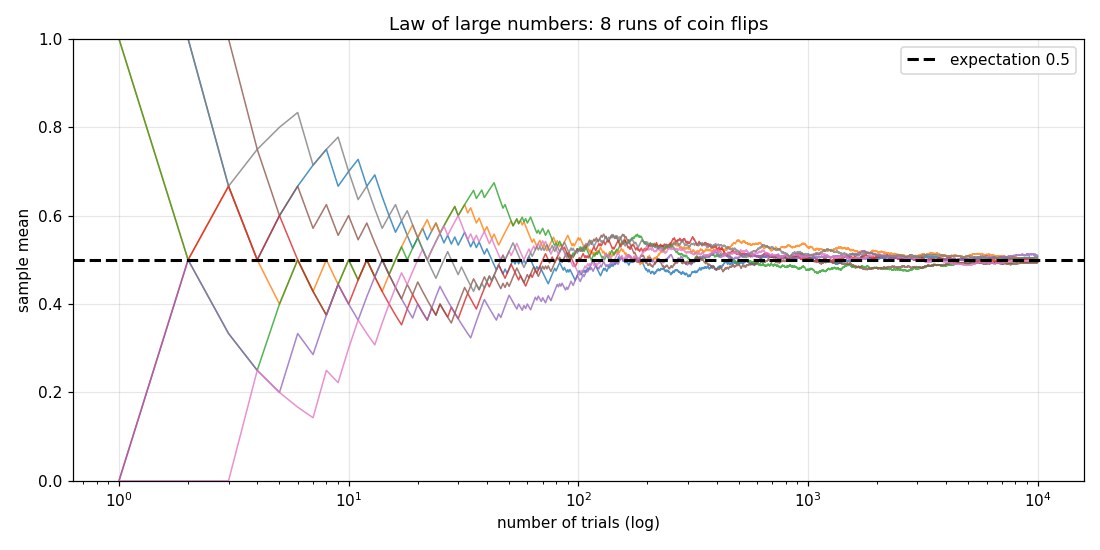
試行回数が少ないうちは系列ごとに大きく異なりますが、1000回を超えるとすべての系列が0.5付近に集まります。
ただし横軸は対数であり、収束は緩やかです。その速さを次節で求めます。
収束の速さ
大数の法則は「期待値に近づく」ことを述べますが、どの程度の速さで近づくかは述べていません。この節ではそれを求めます。結論は次のとおりです。
表の割合の標準偏差 (期待値からの典型的なずれ) は $\sigma/\sqrt{n}$ です。
以下、この式を分散の2つの性質から導きます。
方針 : 表の割合は「表の回数 ÷ $n$」です。そこで、(1) 表の回数の分散を求め、(2) $n$ で割ったときの変化を反映し、(3) 平方根をとって標準偏差に直す、という3段階で計算します。
(1) 表の回数の分散 : $X_1, \ldots, X_n$ は独立なので、性質2より各回の分散 $\sigma^2$ を $n$ 個足します。
$$\mathrm{Var}(X_1 + \cdots + X_n) = n\sigma^2$$
(2) $n$ で割る : $1/n$ 倍なので、性質1より分散は $1/n^2$ 倍になります。
$$\mathrm{Var}(\bar{X}_n) = \frac{n\sigma^2}{n^2} = \frac{\sigma^2}{n}$$
(3) 標準偏差に直す : 平方根をとります。
$$\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{n}}$$
この式から分かるのは、ずれが $1/n$ ではなく$1/\sqrt{n}$ でしか小さくならないことです。精度を10倍にするには試行回数を100倍にする必要があります。測定を4回平均すると誤差が半分になる、という実験誤差の関係と同じです。
コイン投げ ($\sigma = 0.5$) の場合の値を示します。
- $n = 10$ : $0.5/\sqrt{10} \approx 0.16$
- $n = 100$ : $0.5/\sqrt{100} = 0.05$
- $n = 10000$ : $0.5/\sqrt{10000} = 0.005$
この理論値が正しいか、シミュレーションで確かめます。各 $n$ について「$n$ 回投げて割合を求める」操作を400回くり返し、そのばらつきを測ります。
Ns = np.unique(np.logspace(1, 4.5, 25).astype(int))
sd = [(rng.random((400, N)) < 0.5).mean(axis=1).std() for N in Ns]

fig, ax = plt.subplots(figsize=(10, 5))
ax.loglog(Ns, sd, "o", label="simulated")
ax.loglog(Ns, 0.5/np.sqrt(Ns), "-", label=r"$0.5/\sqrt{N}$")
ax.set_xlabel("N")
ax.set_ylabel("std of sample mean")
ax.legend()
plt.show()
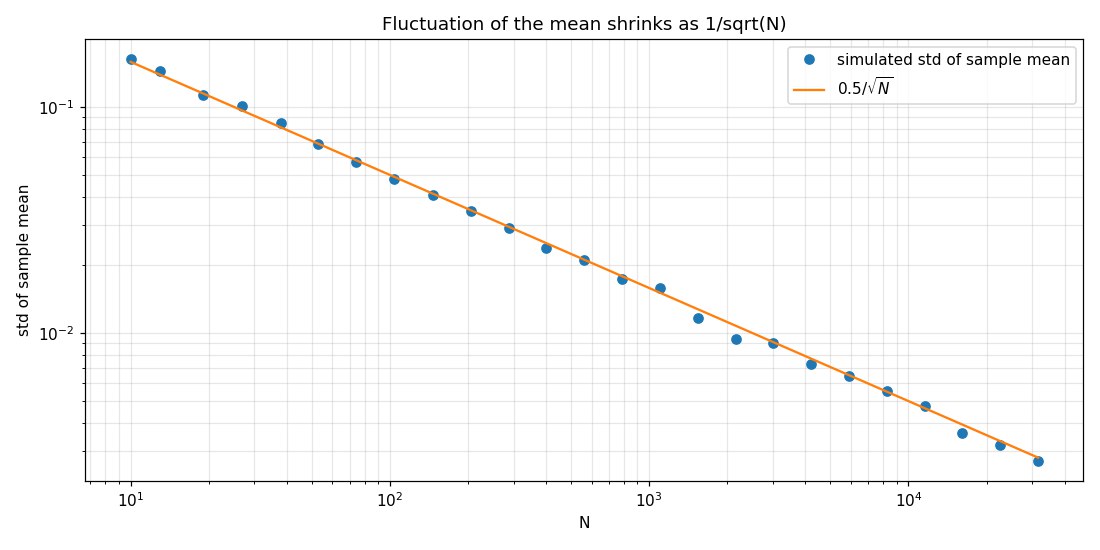
シミュレーション (点) と理論値 $0.5/\sqrt{n}$ (線) はよく一致します。
表と裏の回数の差
表の割合は0.5に近づきますが、表と裏の回数の差はどうなるでしょうか。結論は次のとおりです。
回数の差は $\sqrt{n}$ 程度に増大します。それでも割合のずれは $1/(2\sqrt{n})$ に減少します。
一見矛盾しますが、両者は両立します。まず差の大きさを求め、次に割合との関係を示します。
回数の差の標準偏差
差を扱いやすくするため、$i$ 回目の結果を表なら $+1$、裏なら $-1$ とする量 $\varepsilon_i$ を導入します。表の回数から裏の回数を引いた差 $D_n$ は、その和で表せます。
$$D_n = \varepsilon_1 + \varepsilon_2 + \cdots + \varepsilon_n$$
$\varepsilon_i$ の期待値と分散は、定義どおり計算すると
$$E[\varepsilon_i] = (+1) \times \frac{1}{2} + (-1) \times \frac{1}{2} = 0$$
$$\mathrm{Var}(\varepsilon_i) = (+1)^2 \times \frac{1}{2} + (-1)^2 \times \frac{1}{2} = 1$$
各回は独立なので、性質2より分散は足し算になり、
$$\mathrm{Var}(D_n) = n, \qquad \sigma_D = \sqrt{n}$$
したがって、回数の差は典型的に $\sqrt{n}$ 程度となり、$n$ とともに増大します。これは1回ごとに左右へ1歩ずつランダムに動くランダムウォークと同じ構造です。
割合が収束する理由
差が増大しても割合が収束するのは、割合が差を $n$ で割った量で決まるためです。
表の回数を $H$、裏の回数を $T$ とすると、$H + T = n$、$H – T = D_n$ です。両式を足して $H = (n + D_n)/2$ となるので、表の割合は
$$\bar{X}_n = \frac{H}{n} = \frac{1}{2} + \frac{D_n}{2n}$$
第2項が0.5からのずれです。分子 $D_n$ は $\sqrt{n}$ 程度でしか増えない一方、分母は $n$ で増えるため、
$$\frac{\sqrt{n}}{2n} = \frac{1}{2\sqrt{n}} \to 0$$
これは前節の $\sigma/\sqrt{n}$ に $\sigma = 0.5$ を代入した値と一致します。
数値シミュレーション
差と割合を同じ系列で並べて描き、上記の結論を確かめます。
rng = np.random.default_rng(5)
n = 100000
N = np.arange(1, n+1)

fig, axs = plt.subplots(1, 2, figsize=(12, 5))
for _ in range(6):
    eps = rng.choice([-1, 1], n)      # 表なら +1、裏なら -1
    D = np.cumsum(eps)                # 表の回数 - 裏の回数
    axs[0].plot(N, D, lw=.8)
    axs[1].plot(N, 0.5 + D/(2*N), lw=.8)

axs[0].plot(N, np.sqrt(N), "k--"); axs[0].plot(N, -np.sqrt(N), "k--")
axs[1].plot(N, 0.5 + 1/(2*np.sqrt(N)), "k--"); axs[1].plot(N, 0.5 - 1/(2*np.sqrt(N)), "k--")
for ax in axs:
    ax.set_xscale("log")
plt.show()
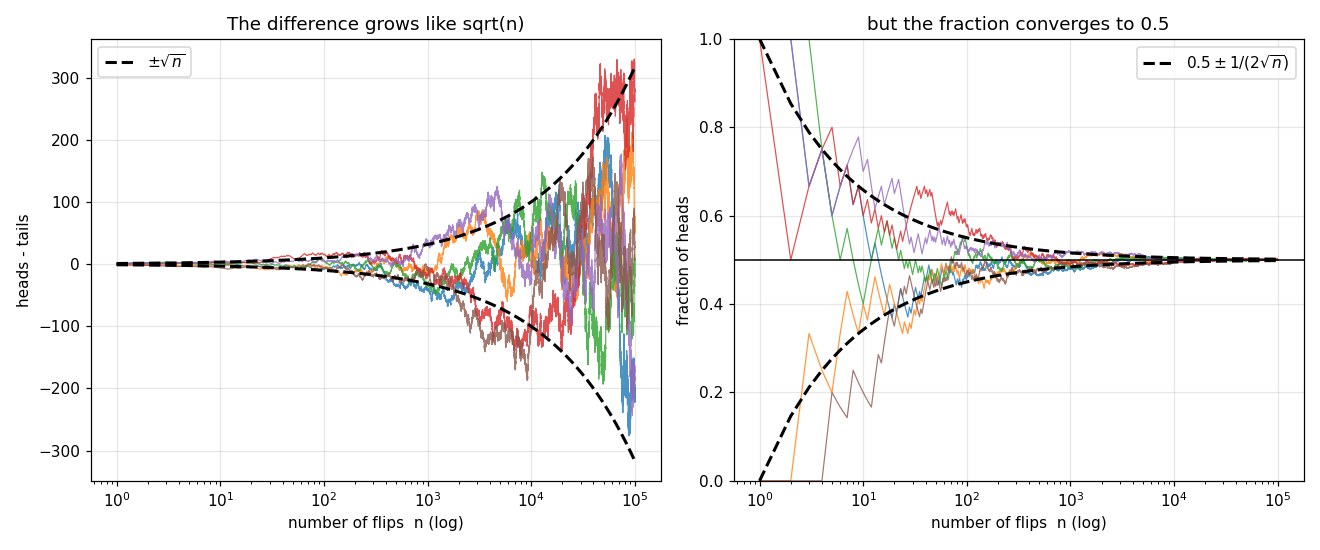
左図は回数の差 $D_n$ (破線は $\pm\sqrt{n}$)、右図は同じ系列の表の割合 (破線は $0.5 \pm 1/(2\sqrt{n})$) です。差は増大する一方、割合は0.5に収束しています。
- $n = 100$ : 差 約10回、割合のずれ 約5%
- $n = 10{,}000$ : 差 約100回、割合のずれ 約0.5%
- $n = 1{,}000{,}000$ : 差 約1000回、割合のずれ 約0.05%
ギャンブラーの誤謬
「表が続いたから、次は裏が出やすい」という考えは誤りです。これをギャンブラーの誤謬と呼びます。
各回は独立であり、次に表が出る確率は常に1/2です。大数の法則は、偏りが後から埋め合わされることを意味しません。前節で示したとおり、回数の差はむしろ増大します。
割合が0.5に近づくのは、差の増え方 ($\sqrt{n}$) より試行回数の増え方 ($n$) が速く、偏りが試行回数によって薄められるためです。
~coffee break~
同じ関係は物理の拡散にも現れます。粒子の変位は時間 $t$ に対して $\sqrt{t}$ で広がりますが、平均の速さ (変位 ÷ 時間) は $1/\sqrt{t}$ で0に近づきます。
中心極限定理との関係
大数の法則と中心極限定理は、標本平均の異なる側面を述べています。
- 大数の法則 : 標本平均が収束する先 (期待値 $\mu$)
- 中心極限定理 : 標本平均のばらつきの分布の形 (正規分布)
本記事で求めた $\sigma/\sqrt{n}$ は、中心極限定理における正規分布の幅に相当します。
投資・ギャンブルへの示唆
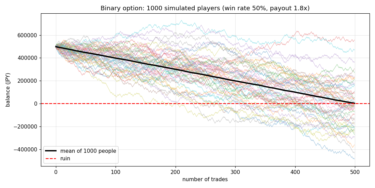
期待値が負のゲームは、くり返すほど損失がほぼ確実になります。短期的に利益が出るのは、まだ収束していないためです。バイナリーオプションを例にしたシミュレーションは、こちらの記事で扱っています。
「バイナリーオプションで稼げる」という話を、SNSや広告で見たことがある方は多いと思います。 先に結論だけ書いておきますね。 バイナリーオプションは、続ければ続けるほど資金が減る仕組みになっています。 […]
一方で、「長期投資なら必ず利益が出る」という主張にも注意が必要です。大数の法則が保証するのは1年あたりの平均リターンが期待値に近づくことであり、資産額そのもののばらつきが小さくなることではありません。コインの回数の差と同様、資産額のばらつきは期間とともにむしろ大きくなります。
まとめ
- 大数の法則 : 試行回数を増やすと、標本平均は期待値に近づく
- 収束の速さ : 標本平均のずれは $\sigma/\sqrt{n}$ (精度10倍には回数100倍)
- 回数の差は $\sqrt{n}$ で増大するが、割合のずれは $1/(2\sqrt{n})$ で減少する
- 偏りは埋め合わされるのではなく、試行回数によって薄められる
- 導出の鍵は、独立な確率変数の和の分散が各分散の和になること
グラフの描き方はこちらで解説しています。
matplotlibとは pythonを用いたグラフ描画ライブラリ。折線グラフやヒストグラム、3次元グラフなどさまざまなグラフをかける。 matplotlib、構文が分かりそうで分からない! 初めて[…]